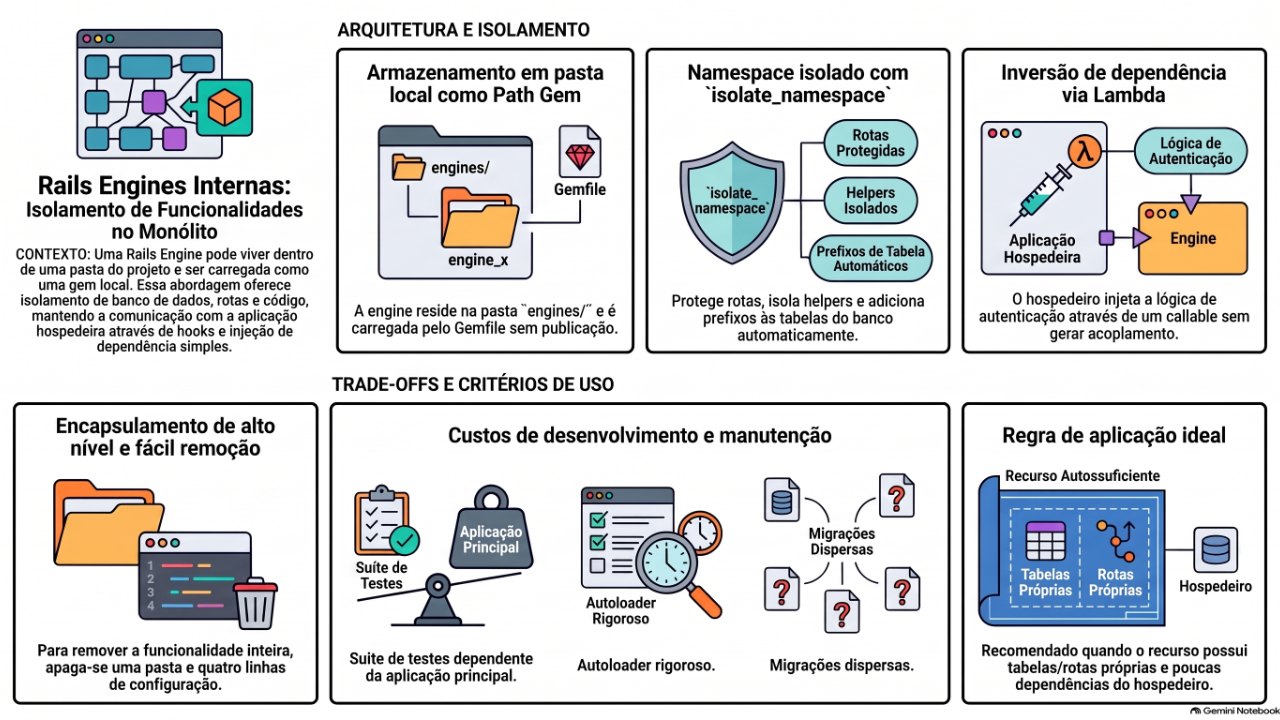
Rails engines: uma gem que mora dentro da sua aplicação
TL;DR
Uma Rails engine pode morar numa pasta do seu app, carregada como gem com `path:`. Com isolate_namespace, tabelas prefixadas e migrations anexadas ao host, uma feature como links curtos vira uma pasta que você entende ou apaga inteira. A única dependência do host é um hook via lambda. O custo: specs, autoloading e visibilidade do schema.
Como construí links curtos com rastreio de cliques como uma Rails engine numa pasta do app principal, com o código real e tradeoffs.
Na semana passada eu precisava de links curtos para uma API Rails. O usuário compartilha um lugar ou uma viagem, o app devolve uma url curta e cada clique fica registrado. Nada difícil. Mas o app principal já tinha 70 tabelas e um config/routes.rb que exige bastante rolagem. Eu não queria somar mais três models, um controller e duas migrations a essa pilha.
Então construí isso como uma engine. Este post reúne o que aprendi, com o código real, um pouco enxugado.
O que é uma engine
Uma Rails engine é uma aplicação Rails sem o código de boot. Ela tem seu próprio app/, config/routes.rb, db/migrate e um gemspec. A aplicação host carrega a engine como qualquer outra gem, monta as rotas dela em um path e roda as migrations dela junto com as demais. O Devise é uma engine. O Mission Control Jobs, o painel de jobs mantido pelo time do Rails, também. Até a sua própria aplicação é uma: Rails::Application herda de Rails::Engine.
O que muita gente não percebe é que a engine não precisa morar em um repositório separado. Dá para mantê-la em uma pasta dentro do projeto e apontar o Gemfile para essa pasta. Você ganha o isolamento de uma gem sem o processo de release de uma gem.
A estrutura
engines/link_tracker/
  link_tracker.gemspec
  lib/link_tracker.rb
  lib/link_tracker/engine.rb
  lib/link_tracker/version.rb
  config/routes.rb
  app/controllers/link_tracker/links_controller.rb
  app/models/link_tracker/application_record.rb
  app/models/link_tracker/link.rb
  app/models/link_tracker/visit.rb
  db/migrate/20261008214407_create_link_tracker_tables.rb
rails plugin new engines/link_tracker --mountable gera a maior parte disso, mais uma dummy app e uma pilha de arquivos que você vai acabar apagando. Preferi escrever tudo à mão. São dez arquivos.
O gemspec
require_relative "lib/link_tracker/version"

Gem::Specification.new do |spec|
  spec.name = "link_tracker"
  spec.version = LinkTracker::VERSION
  spec.authors = ["Wilbert"]
  spec.summary = "Short links and visit tracking"
  spec.files = Dir["{app,config,db,lib}/**/*"]
  spec.required_ruby_version = ">= 2.7"

  spec.add_dependency "rails", ">= 6.0"
end
E no Gemfile do host:
gem "link_tracker", path: "engines/link_tracker"
O Bundler trata uma gem com path: como se fosse uma gem publicada. Se um dia a engine precisar ir para um repositório próprio, essa linha vira git: ou uma versão, e nada mais muda. Gosto de ter essa porta de saída sem pagar por ela hoje.
A classe da engine
Este é o arquivo que transforma tudo isso em uma engine, e não apenas em uma pasta com código Ruby.
module LinkTracker
  class Engine < ::Rails::Engine
    isolate_namespace LinkTracker

    initializer "link_tracker.append_migrations" do |app|
      config.paths["db/migrate"].expanded.each do |path|
        app.config.paths["db/migrate"] << path
      end
    end
  end
end
O isolate_namespace faz três coisas. As rotas dentro da engine não enxergam as rotas do host, então link_path dentro da engine significa o link da engine, e não algum outro resource links do host. Quando a engine realmente precisa de uma rota do host, ela tem que pedir isso de forma explícita via main_app. Os helpers ficam dentro do namespace. E todo model ganha um prefixo de tabela, então LinkTracker::Link lê de link_tracker_links. Esse último ponto é o que mantém o schema do host legível. Você abre o db/schema.rb, vê link_tracker_ e sabe onde procurar.
O initializer adiciona as migrations da engine aos paths de migration do host. Sem ele, você rodaria rails link_tracker:install:migrations, que copia os arquivos para o db/migrate do host. Copiar significa ter duas fontes de verdade. Adicionar ao path significa que o rails db:migrate no host simplesmente encontra essas migrations. Um comando, um lugar.
Tem uma armadilha aqui. Os timestamps das migrations da engine compartilham a mesma sequência com os do host. Se alguém do time criar uma migration no host com o mesmo timestamp, o Rails reclama. Na prática isso nunca aconteceu comigo, mas confiro o número da versão antes de fazer o commit.
Rotas
As rotas da engine:
LinkTracker::Engine.routes.draw do
  get ":slug", to: "links#show", as: :link, constraints: {slug: /[A-Za-z0-9]+/}
end
As rotas do host:
mount LinkTracker::Engine => "/l"
Essa é toda a ligação. GET /l/aB3kQ9xZ é resolvido dentro da engine, e o host não faz ideia do que é um slug. Se amanhã eu mudar o mount para /s, a engine não muda. A engine nunca enxerga o próprio prefixo, e a ideia é exatamente essa.
O model
module LinkTracker
  class Link < ApplicationRecord
    SLUG_LENGTH = 8

    belongs_to :linkable, polymorphic: true
    belongs_to :user, optional: true
    has_many :visits, dependent: :delete_all

    validates :slug, presence: true, uniqueness: true
    validates :target_url, presence: true

    before_validation :assign_slug, on: :create

    def self.register(linkable:, target_url:, user: nil)
      link = find_or_initialize_by(linkable: linkable, user: user)
      link.target_url = target_url
      link.save!
      link
    rescue ActiveRecord::RecordNotUnique
      find_by!(linkable: linkable, user: user)
    end

    def record_visit!(attributes = {})
      visit = visits.create!(attributes.reverse_merge(visited_at: Time.current))
      update_column(:last_visited_at, visit.visited_at)
      visit
    end

    private

    def assign_slug
      return if slug.present?

      loop do
        self.slug = SecureRandom.alphanumeric(SLUG_LENGTH)
        break unless self.class.exists?(slug: slug)
      end
    end
  end
end
Repare no ApplicationRecord do qual ele herda. É o da própria engine:
module LinkTracker
  class ApplicationRecord < ::ApplicationRecord
    self.abstract_class = true
  end
end
O gerador entrega ApplicationRecord < ActiveRecord::Base. Mudei para herdar do ::ApplicationRecord do host porque o host tem um banco primário e uma réplica, e eu queria que as leituras da engine fossem para a réplica, como todo o resto. Isso é um pequeno vazamento no isolamento, e eu aceitei. Isolamento total significaria a engine configurar a própria conexão com o banco, e eu não quero duas configurações de conexão para um único banco.
O único ponto em que a engine precisa do host
As visitas devem ficar associadas a um usuário logado, quando houver um. A engine não sabe como o host faz autenticação. E nem deveria saber. Se soubesse, a engine passaria a depender do host, e o objetivo era justamente evitar isso.
Então a engine pede uma função:
# lib/link_tracker.rb
module LinkTracker
  class << self
    attr_accessor :visitor_resolver

    def visitor_for(request)
      visitor_resolver&.call(request)
    end
  end
end
E o host fornece essa função em um initializer:
# config/initializers/link_tracker.rb
LinkTracker.visitor_resolver = lambda do |request|
  token = request.headers["access-token"]
  next if token.blank?

  session = AuthToken.find_by(access_token: token)
  session.user if session&.active?
end
A engine chama a lambda, recebe um usuário ou nil e guarda o que vier. A lógica de autenticação pertence ao host. Troque o sistema de auth e só o initializer muda.
O controller é curto:
module LinkTracker
  class LinksController < ActionController::Base
    def show
      link = Link.find_by(slug: params[:slug])
      return render(plain: "Link not found", status: :not_found) if link.nil?

      link.record_visit!(
        ip: request.remote_ip,
        user_agent: request.user_agent&.truncate(512),
        referer: request.referer&.truncate(2048),
        user: LinkTracker.visitor_for(request)
      ) unless request.head?

      expires_now
      redirect_to link.target_url, allow_other_host: true
    end
  end
end
Ele herda de ActionController::Base, e não do ApplicationController do host. O controller base do host roda filtros de autenticação e define um current user. Um link curto é público. Herdar do host significaria desligar tudo isso, filtro por filtro. Partir da base do Rails é mais limpo.
Mais um detalhe: o allow_other_host: true. Desde o Rails 7.0, o redirect_to tem proteção contra open redirect e, dependendo dos defaults do seu framework, uma url em outro host gera um log ou levanta ActionController::Redirecting::UnsafeRedirectError. Um link curto aponta para outro lugar por definição. Desligar a proteção aqui é seguro porque o destino vem do banco, e não de params.
Que paradigma é este
Quero ser honesto aqui, porque "engines são boa arquitetura" é uma frase muito repetida sem que ninguém explique o porquê.
A engine é orientada a objetos do jeito comum do Rails. Link é um objeto com estado e comportamento. Nada novo.
A parte interessante é a fronteira. A lambda visitor_resolver é inversão de dependência. A engine define o que precisa, uma função que recebe um request e devolve um usuário, e o host fornece essa função. O módulo de baixo nível (auth) depende da interface que o módulo de alto nível (rastreio de links) declarou. Esse é o D do SOLID, e uma lambda é a menor interface possível para isso. Sem classe abstrata, sem adapter pattern, sem registry. Um único callable.
Também tem um lado funcional. visitor_for recebe um request e devolve um valor. PartnerLink.target_url(poi, partner), na versão completa, é uma função de módulo que recebe dados e devolve uma url ou nil, sem estado nenhum. Recorro a funções de módulo quando aquilo é um cálculo, e não uma coisa. O Ruby deixa você misturar esses estilos, e acho que essa é uma das suas melhores qualidades. O model é um objeto porque um link tem identidade e ciclo de vida. A validação da url é uma função porque não tem nada disso.
E a engine como um todo trata de encapsulamento no nível do módulo, não da classe. Classes escondem seus detalhes internos de outras classes. Uma engine esconde uma feature inteira do resto do app. As tabelas dela têm prefixo. As rotas dela têm um ponto de montagem. A única dependência que ela tem do host é um hook com nome. Quando quero entender o rastreio de links, abro uma pasta. Quando quero apagá-lo, removo uma pasta, uma linha do Gemfile, uma linha de mount e um initializer.
Essa é a régua que uso hoje. Quantos lugares preciso tocar para remover esta feature? No caso da engine, são quatro, e cada um é uma linha só. Com a mesma feature espalhada pelo app/, eu estaria rodando grep.
Onde engines doem
Elas não saem de graça. Três coisas atrapalharam.
Specs. Os testes da engine rodam dentro da suíte de testes do host, porque a engine herda o ApplicationRecord do host e precisa do banco do host. Uma engine standalone viria com uma dummy app para isso. Eu pulei essa parte. Se você quer que a engine seja testável sozinha, paga pela dummy app logo no início.
Autoloading. O Zeitwerk espera que app/models/link_tracker/link.rb defina LinkTracker::Link. Erre o aninhamento e você ganha um erro de carregamento confuso, que não menciona nenhum dos dois arquivos. Siga a convenção à risca.
Schema drift. Como as migrations moram em engines/, quem revisa passando o olho em db/migrate não vai vê-las. No meu PR, o review automático apontou mudanças de schema "sem nenhuma migration por trás". As migrations estavam lá, só não onde ele procurou. Diga na descrição do PR onde as migrations estão.
Quando fazer isso
Eu não construiria uma engine para cada feature. A maior parte de uma aplicação Rails é a própria aplicação, e dividi-la em vinte engines te dá vinte gemspecs e o mesmo acoplamento, só que com mais pastas.
Essa feature era uma boa candidata porque tem tabelas próprias, uma rota pública própria, nenhuma view e exatamente uma coisa que precisa do host. Se uma feature precisa de cinco coisas do host, ela faz parte do host. Se precisa de uma, dê a ela uma pasta e um gemspec.
O código acima é uma versão reduzida de uma engine que funciona de verdade. A versão completa também trata links de parceiros (um slug por lugar e por parceiro, sem usuário) e ignora visitas de bots de preview de link. Mesma estrutura, algumas linhas a mais.
Fontes
- Getting Started with Engines (Rails Guides) guides.rubyonrails.org
- Documentação da API de Rails::Engine api.rubyonrails.org
- ActionController::Redirecting#redirect_to e allow_other_host api.rubyonrails.org
- Referência do Gemfile: gems com path (Bundler) bundler.io
- Zeitwerk: estrutura de arquivos e nomes de constantes github.com
- Mission Control Jobs (engine do time do Rails) github.com
- Devise (engine de autenticação) github.com
Perguntas frequentes
Uma Rails engine precisa ser um repositório separado ou uma gem publicada?
Não. Mantenha a engine numa pasta dentro do app e referencie com `gem "link_tracker", path: "engines/link_tracker"`. O Bundler carrega como qualquer gem, e mover para um repositório próprio depois é uma mudança de uma linha no Gemfile.
O que o isolate_namespace faz de fato?
Ele restringe rotas e helpers ao escopo da engine: os helpers de rota dentro dela resolvem para as rotas da própria engine, rotas do host exigem `main_app`, e todo model ganha um prefixo de tabela como `link_tracker_links`.
Devo copiar as migrations da engine para o host ou anexá-las?
Anexe num initializer, adicionando o `db/migrate` da engine em `app.config.paths["db/migrate"]`. Copiar com `rails engine:install:migrations` cria duas fontes de verdade; anexar faz o `rails db:migrate` encontrá-las no lugar.
Como a engine usa a autenticação do host sem depender dele?
A engine expõe uma lambda configurável, `LinkTracker.visitor_resolver`, que recebe um request e devolve um usuário ou nil. O host a define num initializer. Trocar o sistema de auth só toca esse initializer.
Os controllers da engine devem herdar do ApplicationController do host?
Para um endpoint público como um link curto, não. Herde de `ActionController::Base` para não precisar desligar os filtros de auth do host um por um.
Quando uma feature é uma má candidata para virar engine?
Quando ela precisa de muitas coisas do host. Uma boa candidata tem tabelas e rotas próprias e pede uma única coisa ao host. Dividir o app inteiro em várias engines só dá mais gemspecs com o mesmo acoplamento.
Comentários
Faça login com GitHub para comentar.
Ainda não há comentários.