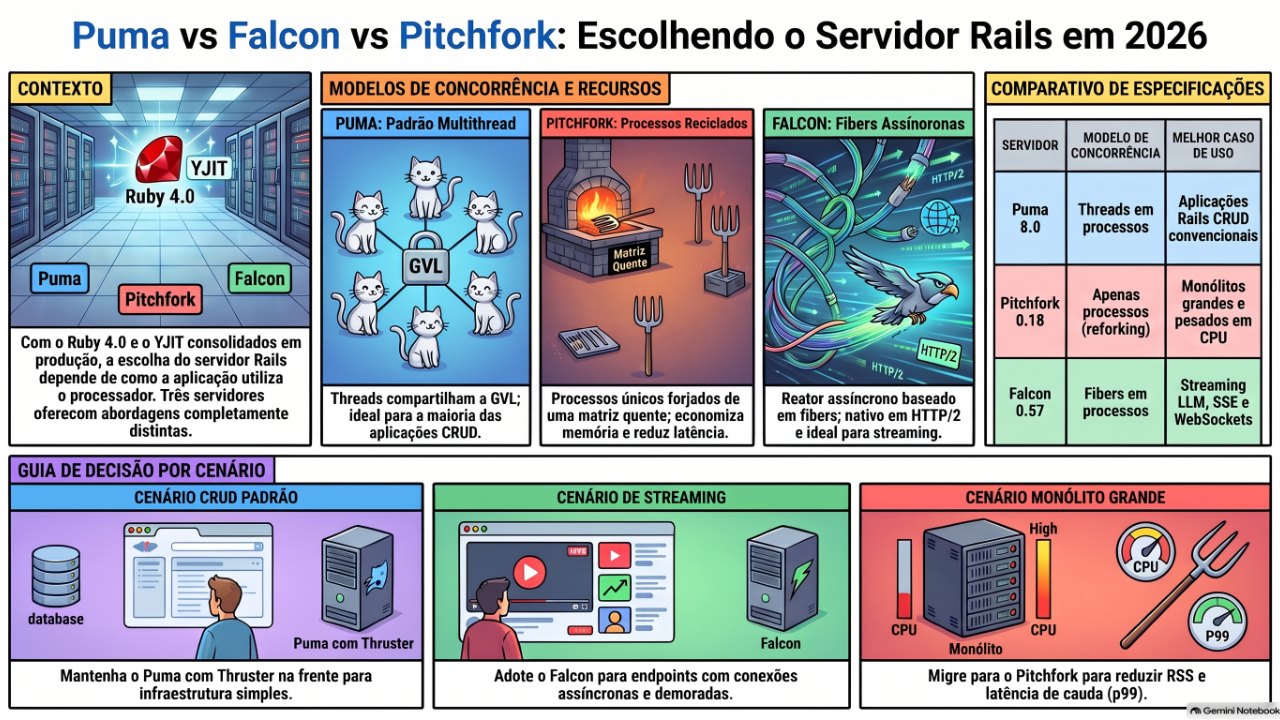
Puma, Falcon ou Pitchfork? Escolhendo o servidor de aplicação Rails em 2026
TL;DR
Puma segue como padrão certo para a maioria das apps Rails e ganhou ajustes úteis no 8.0. Pitchfork vence em memória e latência de cauda em monólitos grandes e pesados em CPU, com time que assuma o fork safety. Falcon é a escolha para streaming de LLM, SSE e WebSocket. Escolha pela carga, meça p99 e RSS.
Threads, fibers ou processos forkados? Um comparativo prático entre Puma 8, Falcon 0.57 e Pitchfork 0.18 para Rails no Ruby 4, com configs e decisão por cenário.
Toda aplicação Rails nasce com Puma, e para a maioria delas a história termina aí. Mas 2026 é o primeiro ano em que a pergunta merece uma resposta de verdade. Ruby 4.0 está em produção, YJIT é o JIT padrão, a Shopify roda o monólito em Pitchfork há três anos e o Falcon chegou ao ponto em que falcon-rails é uma instalação de uma linha. Três servidores, três modelos de concorrência, e a escolha certa depende do que a sua aplicação realmente faz com um core de CPU.
Este post fecha a trilogia de infraestrutura que começamos com Solid Queue ou Sidekiq e as sete camadas de cache. Jobs, cache, e agora o processo que atende a requisição.
Os três modelos de concorrência em um parágrafo
Puma roda N processos worker, cada um com um pool de M threads. As threads compartilham o GVL, então dentro de um processo só uma thread executa código Ruby por vez, mas threads esperando I/O liberam o lock. Pitchfork roda N processos de thread única, forkados de um "mold" já aquecido, sem threads. Falcon roda N processos, cada um atendendo milhares de requisições em fibers leves agendadas pelo reactor do async; uma fiber bloqueada em I/O cede a vez para a próxima sem troca de thread do sistema operacional.
O GVL continua lá no Ruby 4.0. Ractors receberam melhorias reais (Ractor::Port, menos estado interno compartilhado, melhor comportamento de cache), mas o Rails não atende requisições a partir de Ractors e nenhum dos três servidores os usa. Então, para uma requisição web, paralelismo ainda significa processos, e concorrência significa threads ou fibers. É essa restrição que torna a escolha interessante.
O que mudou em 2026
Puma 8.0 saiu em abril de 2026, e o 8.0.2 em maio fechou dois problemas no protocolo PROXY. As novidades relevantes para planejamento de capacidade são workers :auto (desde o 7.2), a configuração max_io_threads com env["puma.mark_as_io_bound"] para que requisições de streaming e long-poll possam ultrapassar o pool de threads normal, e o redimensionamento do pool em tempo de execução via update_thread_pool_min_max. A única mudança incompatível: em produção o bind agora é em :: (IPv6) quando existe uma interface IPv6 que não seja loopback, com fallback para 0.0.0.0. Se a rede do seu container é só IPv4, isso é invisível; se é dual-stack, confira os health checks.
Pitchfork 0.18.2 (janeiro de 2026) é maduro e deliberadamente sem graça. O próprio texto do Jean Boussier é explícito em não querer "hype de Pitchfork": reforking é uma ferramenta para times que conseguem depurar bugs de fork-safety, e os números de produção na Shopify foram cerca de 30% menos memória e aproximadamente 9% menos latência em comparação com o Unicorn.
Falcon 0.57.0 (agosto de 2026) exige Ruby 3.3+, adicionou métricas de utilização, um CompositeServer para hospedar várias instâncias de servidor em um único worker, e traz uma Railtie que muda config.active_support.isolation_level para :fiber automaticamente. Fala HTTP/1.1 e HTTP/2 nativamente, incluindo TLS, sem proxy na frente.
Puma: o padrão, agora com os ajustes que importam
O Rails 8 gera um config/puma.rb com RAILS_MAX_THREADS em 3 por padrão, WEB_CONCURRENCY controlando os workers, e o Thruster na frente para HTTP/2, compressão e X-Sendfile. Para a esmagadora maioria das aplicações CRUD isso está correto e você deve deixar como está.
A configuração da era 2026 que vale copiar é a que usa fork_worker para ter reforking no estilo Pitchfork sem trocar de servidor:
# config/puma.rb
workers ENV.fetch("WEB_CONCURRENCY") { :auto }
max_threads = Integer(ENV.fetch("RAILS_MAX_THREADS", 3))
threads max_threads, max_threads

# O worker 0 carrega a app; os outros workers são forkados dele.
# Depois de 1000 requisições no worker 0, o Puma reforka a frota
# a partir do worker já aquecido. Não combine com preload_app!.
fork_worker 1000

# Permite que streaming de LLM ou SSE ultrapasse o pool normal.
max_io_threads 8

port ENV.fetch("PORT", 3000)
plugin :tmp_restart
plugin :solid_queue if ENV["SOLID_QUEUE_IN_PUMA"]
Duas pegadinhas. fork_worker e preload_app! são mutuamente exclusivos, porque o worker 0 é quem faz o preload. E max_io_threads só ajuda se você marcar a requisição: no controller, request.env["puma.mark_as_io_bound"] = true antes de começar o streaming.
Threads também são onde o Puma dói. Três threads compartilhando um GVL em uma action CPU-bound significa que a latência de cauda sobe com carga, e a única cura é mais processos, o que significa mais memória. É exatamente o problema para o qual o próximo servidor foi construído.
Pitchfork: Unicorn com o coração aquecido
Pitchfork é um fork do Unicorn com uma grande ideia. Em vez de forkar workers a partir de um master recém-iniciado e assistir às páginas de copy-on-write serem copiadas conforme cada worker aquece (inline caches, código do YJIT, constantes memoizadas), ele promove um worker que já atendeu tráfego a um novo "mold" e reforka a frota a partir dele. As páginas compartilhadas continuam compartilhadas, e substituir um worker que caiu te dá um processo aquecido em vez de um frio.
# config/pitchfork.rb
worker_processes Integer(ENV.fetch("WEB_CONCURRENCY", 8))
listen ENV.fetch("PORT", 3000)
timeout 30

# Reforka após 50 requisições, depois 100, depois a cada 1000.
refork_after [50, 100, 1000]

after_mold_fork do |server, mold|
  # Aqueça o que puder antes que os workers sejam forkados deste mold.
  Rails.application.eager_load!
end

after_worker_fork do |server, worker|
  # Rails 7.1+ reconecta o Active Record automaticamente via ForkTracker.
end
bundle exec pitchfork -c config/pitchfork.rb -E production
As restrições são reais. O reforking depende de PR_SET_CHILD_SUBREAPER, então é só Linux; no macOS em desenvolvimento ele roda sem reforking. Cada worker tem thread única, então uma aplicação com chamadas HTTP externas lentas vai precisar de mais processos do que precisaria de threads no Puma. E tudo que abre uma conexão, cria uma thread ou guarda um file descriptor no boot precisa ser fork-safe, porque o processo que o segura vai ser forkado de novo no meio da vida, não só na inicialização. A orientação do Boussier é direta: se você é uma grande loja de Unicorn, migre; se quer um Unicorn modernizado sem reforking, também vale; fora isso, provavelmente não precisa.
Em memória, a diferença é dramática no caso pequeno. O micro-benchmark inicial dele tinha o Puma com 2 workers e 2 threads usando cerca de 600 MiB, enquanto o Pitchfork com 4 processos usava cerca de 320 MiB. É muita folga em um VPS com Kamal.
Falcon: fibers, HTTP/2 e o caso de uso de streaming
O Falcon faz a aposta oposta. Um processo, muitas fibers, e toda chamada de I/O bloqueante dentro do fiber scheduler do Ruby vira um ponto de cessão. Uma requisição esperando o Postgres, o Redis ou uma API externa custa quase nada enquanto espera. É por isso que ele é o servidor natural para streaming de LLM com RubyLLM, Server-Sent Events e aplicações pesadas em WebSocket: mil streams abertos são mil fibers estacionadas, não mil threads ou processos.
# Gemfile
gem "falcon-rails"
#!/usr/bin/env -S falcon host
# falcon.rb
require "falcon/environment/rack"

service "myapp" do
  include Falcon::Environment::Rack

  preload "preload.rb"
  count Integer(ENV.fetch("WEB_CONCURRENCY", 4))

  endpoint Async::HTTP::Endpoint
    .parse("http://0.0.0.0:#{ENV.fetch('PORT', 3000)}")
    .with(protocol: Async::HTTP::Protocol::HTTP11)
end
# preload.rb
require_relative "config/environment"
Os tradeoffs são sobre o ecossistema, não sobre o servidor. Toda gem no caminho da requisição precisa fazer I/O pela camada de IO do Ruby ou por um driver que conheça o scheduler. O pg suporta o fiber scheduler; confira o driver MySQL que você usa antes de assumir. Uma extensão em C que bloqueia em código nativo trava o reactor inteiro, o que é pior do que travar uma thread do Puma. Seu pool do Active Record precisa ser dimensionado para fibers concorrentes, não threads, então o pool no database.yml precisa subir, e qualquer coisa que assumia Thread.current como estado local da requisição precisa respeitar o isolation level :fiber que a Railtie do Falcon define. Actions CPU-bound não ganham nada: o GVL continua sendo um lock por processo, com fibers ou sem.
Comparativo
| Puma 8.0 | Pitchfork 0.18 | Falcon 0.57 | |
|---|---|---|---|
| Unidade de concorrência | Threads em processos | Só processos | Fibers em processos |
| CPU em paralelo | Por processo | Por processo | Por processo |
| Throughput I/O-bound | Bom | Precisa de mais processos | Excelente |
| Memória por unidade | Média | Menor com reforking | Menor por conexão |
| Latência de cauda sob CPU | Degrada com threads | Melhor (sem disputa de GVL) | Degrada como o Puma |
| Streaming / SSE / WebSocket | OK com max_io_threads | Fraco | Nativo |
| HTTP/2 | Via Thruster | Via proxy | Nativo, com TLS |
| Carga de fork-safety | Moderada (fork_worker) | Alta (reforking) | Baixa |
| Carga de fiber-safety | Nenhuma | Nenhuma | Alta |
| Plataformas | Todas | Linux para reforking | Todas |
| Padrão do Rails | Sim | Não | Não |
Meça antes de trocar
Toda migração de servidor que eu vi dar errado começou com um benchmark de endpoints hello-world. Meça a sua aplicação, com o formato do seu tráfego, em três números: latência p99, RSS por worker depois de uma hora de tráfego, e a fração do tempo de requisição gasta esperando o GVL.
O último é o que decide entre Puma e Pitchfork, e a instrumentação gvl_timing que chegou no Ruby 3.2 torna a coleta barata. Envolva em um middleware Rack ou use a gem gvltools e envie o número para o seu APM como métrica customizada:
# config/initializers/gvl_metrics.rb
require "gvltools"
GVLTools::LocalTimer.enable

ActiveSupport::Notifications.subscribe("process_action.action_controller") do |*, payload|
  waited_ms = GVLTools::LocalTimer.monotonic_time / 1_000_000.0
  GVLTools::LocalTimer.reset
  StatsD.histogram("rails.gvl_wait_ms", waited_ms, tags: ["action:#{payload[:action]}"])
end
Se a espera pelo GVL é uma fatia relevante do p99 nas suas actions quentes, as threads estão brigando entre si e o Pitchfork (ou menos threads no Puma com mais workers) vai ajudar. Se está perto de zero e ainda há latência, o tempo está em I/O, e a direção é Falcon ou mais threads no Puma. Se a reclamação é RSS e a espera pelo GVL é baixa, comece com fork_worker e jemalloc antes de encostar no servidor.
Para o teste de carga em si, reproduza o formato do tráfego de produção em vez de uma mistura sintética. Uma varredura de WEB_CONCURRENCY em uma máquina de staging com o mesmo tipo de instância basta: 2, 4, 8 processos, cada um com a quantidade de threads ou fibers que você pretende rodar, registrando os três números por combinação. Uma tarde disso produz uma decisão melhor do que qualquer benchmark de blog post, este incluído.
Decisão por cenário
App CRUD padrão, um servidor com Kamal, time com menos de dez pessoas. Puma, como gerado, com Thruster na frente. Adicione fork_worker quando tiver tráfego real. Nada mais compensa a novidade operacional.
API ou app com streaming de LLM, SSE ou milhares de conexões WebSocket ociosas. Falcon para esse serviço. Se o resto da aplicação é convencional, divida: Puma para a app principal, um serviço Falcon pequeno para os endpoints de streaming atrás do mesmo proxy. Não mova um monólito legado grande para o Falcon de uma vez; audite as gems primeiro.
Monólito grande, limitado por memória, actions pesadas em CPU, time de plataforma de sobreaviso. Pitchfork. Os ganhos de memória e de latência de cauda são os que a Shopify mediu, e seu time consegue assumir a auditoria de fork-safety. Comece sem reforking, meça, depois ligue o refork_after.
Já está no Puma e bateu no limite de memória. Antes de trocar, tente fork_worker, jemalloc e o ajuste de RUBY_GC_HEAP_*. Isso recupera a maior parte da história de memória do Pitchfork com zero migração.
Ruby 4.1 e ZJIT. Nada disso muda a escolha do servidor. O ZJIT ainda é experimental no 4.0 e o YJIT é o JIT de produção. Qualquer JIT favorece processos aquecidos e de vida longa, que é o argumento do reforking de novo; não favorece o modelo de concorrência de um servidor sobre o outro.
A versão curta
Puma é o padrão certo e ficou melhor em 2026. Pitchfork é a ferramenta certa para um tipo específico de dor, e o próprio autor vai te dizer para não usar fora disso. Falcon é a ferramenta certa para um tipo específico de carga, e finalmente ficou fácil colocá-lo ao lado de uma aplicação Rails em vez de no lugar dela. Escolha pela carga de trabalho, meça p99 e RSS, e mantenha o Thruster ou um proxy na frente seja qual for o caminho.
Fontes
- Puma no RubyGems (8.0.2) rubygems.org
- Changelog do Puma (History.md) github.com
- Pitchfork no RubyGems (0.18.2) rubygems.org
- Pitchfork: documentação de Reforking github.com
- Jean Boussier: The Pitchfork Story byroot.github.io
- Falcon no RubyGems (0.57.0) rubygems.org
- Falcon: guia de integração com Rails socketry.github.io
- gem gvltools (instrumentação do GVL) github.com
- Ruby 4.0.0 Released www.ruby-lang.org
- Rails 8: No PaaS Required (Thruster e Kamal 2) rubyonrails.org
Perguntas frequentes
O Puma ainda é a melhor escolha para uma app Rails 8 nova?
Sim. A configuração gerada com o Thruster na frente cobre o caso comum, e o Puma 8 adicionou workers :auto, max_io_threads e redimensionamento do pool em tempo de execução. Troque só quando conseguir nomear a métrica que o outro servidor vai corrigir.
O Ruby 4.0 remove o GVL?
Não. O Ruby 4.0 melhorou os Ractors, mas o Rails não atende requisições a partir de Ractors e nenhum dos três servidores os usa. Dentro de um processo só uma thread executa Ruby por vez, então o paralelismo ainda vem de processos.
Dá para ter o benefício do reforking do Pitchfork sem sair do Puma?
Em grande parte, sim. O modo fork_worker do Puma carrega a app no worker 0 e reforka os outros workers a partir dele depois de uma contagem de requisições. Não é compatível com preload_app! e carrega as mesmas exigências de fork-safety, mas evita uma migração de servidor.
O que quebra quando movo uma app Rails para o Falcon?
Tudo que bloqueia em código nativo sem passar pela camada de IO do Ruby, gems que não conhecem o scheduler, um pool do Active Record dimensionado para threads em vez de fibers, e código que guardava estado da requisição em Thread.current. Audite o caminho da requisição antes de trocar.
O Pitchfork funciona no macOS?
Roda, mas o reforking não. O reforking depende de PR_SET_CHILD_SUBREAPER, que é exclusivo do Linux, então o desenvolvimento no macOS se comporta como um servidor preforking comum e a produção em Linux recebe o ganho de memória.
Comentários
Faça login com GitHub para comentar.
Ainda não há comentários.